推論時計算(Inference-time scaling / Test-time compute)の普及は、AIのボトルネックを「モデルの学習(Training)」から「モデルの運用(Inference)」へと根本的にシフトさせている。

単にモデルを大きくする時代から、ユーザーの要求に応じて推論時に数秒〜数分間の「熟考(思考の連鎖や試行錯誤)」を行わせる時代へ移行したことで、推論コスト・電力消費・データセンターインフラの全レイヤーに不可逆な変革が起きている。
1. 推論コストの変容:学習から推論主導へ

従来は「巨額の学習コスト(数億ドル〜)を払えば、推論時は1クエリあたり数分の1セント」という収益構造だった。しかし推論時計算の登場により、この構造が崩れつつある
• 1クエリあたりコストの跳躍:
従来の単純な一発回答型LLMでは、1クエリ(情報を要求する命令文や検索ワード)あたりの消費トークン数(AIがテキストを処理したときの単位(トークン)の合計消費量)は数百程度だったが、推論時計算モデル(例: OpenAI o1/o3やDeepSeek R1など)は内部で数万トークンの思考・自己検証・再生成を行うため、1クエリあたりの実効計算コストが数倍〜100倍以上に膨れ上がる。
• ライフサイクルコストの逆転:
AIモデルのライフサイクル全体において、従来は学習段階が計算リソースの大半を占めていたが、推論時計算の定着により全体の計算リソースや予算の80〜90%が推論に消費される構造へと変化している。
• コスト抑制に向けた技術競争:
このコスト増に対向するため、モデル蒸留(Distillation)、推論専用ASIC/LPU(大規模言語モデル(LLM)の推論処理に特化して開発された専用の半導体)の導入、プロセス報酬モデル(PRM、大規模言語モデルなどが最終的な答えだけでなく、回答に至るまでの「途中の思考プロセス(各ステップ)」が正しいかどうかを段階的に評価・採点する仕組み)の軽量化など、「思考精度を落とさずに推論時計算量を削る」最適化技術が急速に進化している。
2. 電力消費への直撃:1クエリのエネルギー密度の跳躍

推論時計算の拡大は、データセンターの電力需要を二次関数的に押し上げる最大の要因となっている。
【従来型LLMクエリ】 約 0.2 ~ 0.3 Wh (検索数回分)
│
▼ (推論時計算・自律エージェントの導入)
【長文思考・推論クエリ】 約 10 ~ 50+ Wh (数万トークンの試行錯誤)
• クエリ単位での電力差(100倍超):
Our World in Data の分析や国際エネルギー機関(IEA)のデータによると、従来のテキスト回答型クエリが1回あたり約0.2〜0.3 Wh程度であるのに対し、論理推論や自律的試行を行うエージェント型のクエリは1回あたり50 Wh以上を消費するケースがある。
• 「数%のロング推論」が全体を倍増させるリスク:
Microsoft Research の試算では、全リクエストのうちわずか10%が長時間の推論時計算を伴うクエリに置き換わるだけで、データセンター全体の総電力消費量が2倍以上に跳ね上がる可能性があると指摘されている。
• 世界的な電力需要への影響:
世界のデータセンター全体の消費電力は、2024年時点の約400〜500 TWh規模から、2030年には1,000 TWh前後(日本の年間総発電量に匹敵)へと倍増すると予測されている。この成長の主な牽引役が、推論時計算を伴う高度なAIサービスの爆発的普及だ。
3. データセンターインフラへの物理的影響
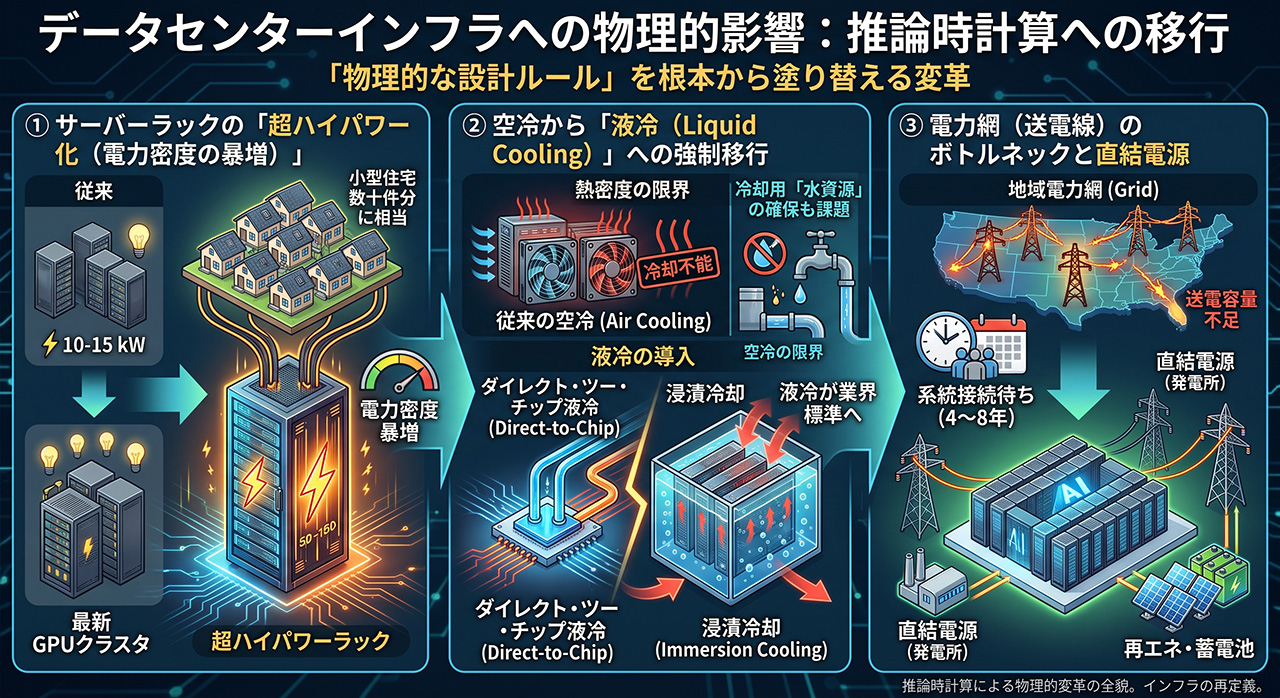
推論時計算への移行は、データセンターの「物理的な設計ルール」を根本から塗り替えている。
① サーバーラックの「超ハイパワー化(電力密度の暴増)」
従来のデータセンターは、1ラック(棚)あたり10〜15 kW程度の電力消費を前提に設計されていた。
しかし、推論時計算を処理する最新のGPU/加速器クラスタでは、1ラックあたり50〜150 kWという極めて高い電力密度が必要となる。単一のラックに、小型住宅数十件分に相当する電力を集中的に給電する必要がある。
② 空冷から「液冷(Liquid Cooling)」への強制移行
熱密度の限界から、従来のファンによる「空気冷却(Air Cooling)」では集中的な推論処理を行うGPUを冷やしきれなくなっている。
そのため、チップに直接冷却液を循環させる「ダイレクト・ツー・チップ(Direct-to-Chip)液冷」や、サーバーごと液体に浸す「浸漬冷却(Immersion Cooling)」への移行が業界標準となりつつある。これに伴い、データセンターの冷却用「水資源」の確保も深刻な課題となっている。
③ 電力網(送電線)のボトルネックと直結電源
地域電力網(Grid)の送電容量不足と系統接続待ち(4〜8年かかるケースも存在)が世界的な問題になっている。
これに対応するため、大手ビッグテック(ハイパースケール事業者)は以下のような戦略をとっている。
• オンサイト発電・直結型DC:送電網を介さず、発電所の隣にデータセンターを建設。
• 原子力・SMR(小型モジュール炉)の長期確保:24時間365日安定したベースロード電源を得るため、原子力発電所の電力長期購入契約(PPA)やSMR開発企業への出資を加速。
• 再生可能エネルギー+蓄電池:太陽光・風力発電と大型蓄電池(BESS)を組み合わせた専用電源の確保。
4. インフラ運用のパラダイムシフト
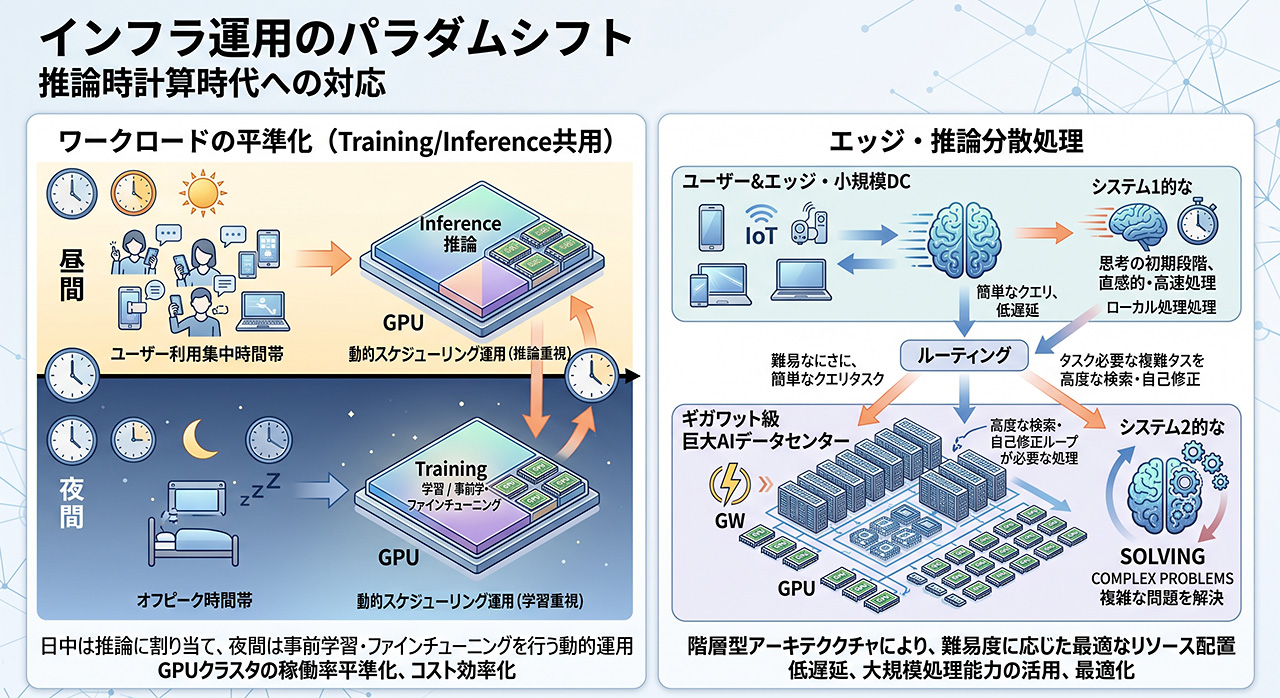
推論時計算時代に対応するため、インフラ運用自体も進化している。
• ワークロードの平準化(Training/Inference共用):
日中のユーザー利用が集中する時間帯はGPUリソースを推論時計算に割り当て、夜間のオフピーク時間帯に同じGPUクラスタでモデルの事前学習やファインチューニングを行う動的スケーリング運用。
• エッジ・推論分散処理:
思考の初期段階(システム1的・高速処理)はユーザーに近いエッジ機器や小規模DCで処理し、高度な検索・自己修正ループ(システム2的・推論時計算)が必要な処理のみをギガワット級の巨大AIデータセンターにルーティングする階層型アーキテクチャ。
推論時計算により、増々データーセンターの巨大化が進み、最先端技術がなんと巨大なインフラと化しているという、何やら妙な時代に突入している。エコとは真逆のこの傾向をそのまま暴走させても良いものか?