LLMをローカルで動かすメリットは認めつつも、ある程度の能力の環境を作るのにどの位の投資が必要だろうか。現在、ゲーミング用など個人向けのハイエンドPCといえば40万円くらいが主流だ。それならもう一声奮発して50万円級である程度の性能のLLMをローカルで運用できるのだろうか。
そこで、70B以上の超大型モデルを4-bit量子化で動かした場合の性能と、50万円前後のMac Studioでの運用可否について検討してみた。
4-bit量子化での性能:十分以上に実用的

70Bクラス以上のモデルであれば、4-bit量子化(GGUFの Q4_K_M や IQ4_XS など)でも非常に高い性能を発揮する。
• スケールによる量子化耐性: 70B以上の超大型モデルは元の表現力とパラメータの余裕が圧倒的であるため、4-bit化による精度低下はわずかだ(FP16元の性能の90〜95%以上を維持する)。
• 小型モデルとの違い: 7B〜13Bなどの小型モデルを4-bit化すると精度劣化が顕著に現れるが、70Bの4-bitモデルは、13Bの16-bit(FP16)や30Bの8-bitよりもはるかに優れた推論力・論理思考力・コード生成力を発揮する。
• 実用性: 複雑なロジック処理や長文の要約、専門的なコード作成などにおいても、FP16との性能差を体感で感じ取るのは困難なレベルという。
50万円前後のMac Studioでの運用:メモリ増設モデルで可能
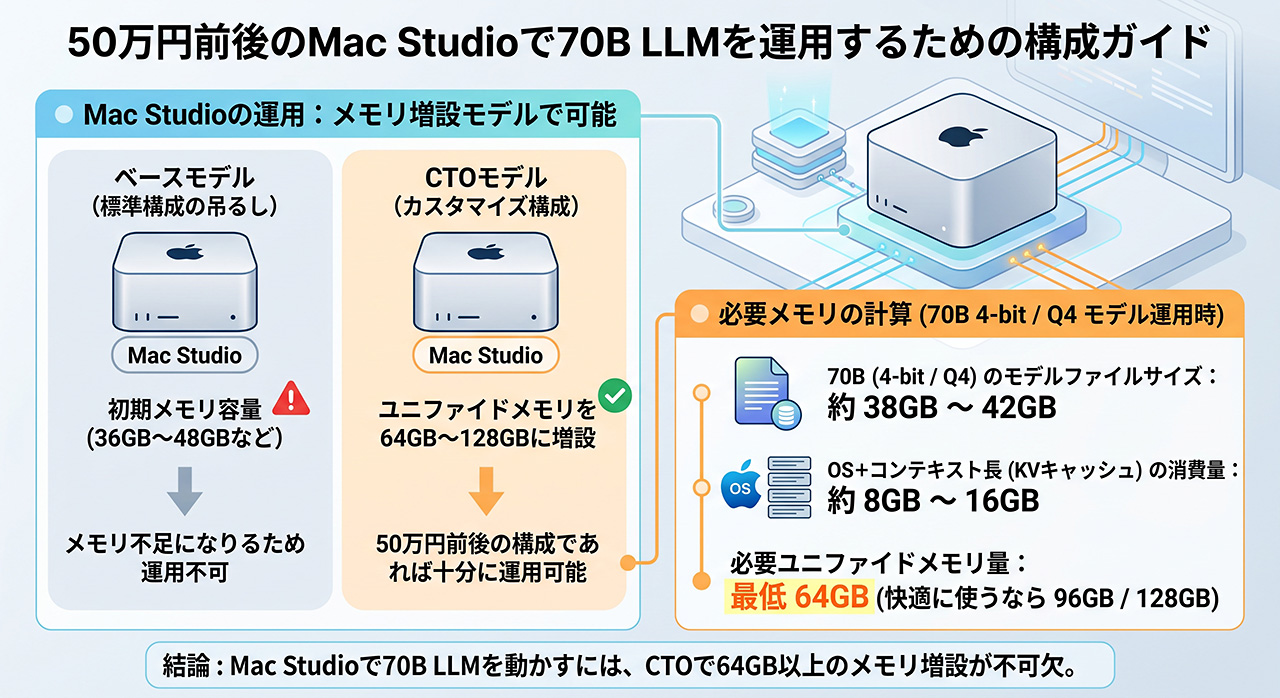
ベースモデル(標準構成の吊るしモデル)の初期メモリ容量(36GB〜48GBなど)ではメモリ不足になるので、CTO(カスタマイズ)でユニファイドメモリを64GB〜128GBに増設した50万円前後の構成であれば十分に運用可能だ。
必要メモリの計算
• 70B(4-bit / Q4)のモデルファイルサイズ: 約 38GB 〜 42GB
• OS+コンテキスト長(KVキャッシュ)の消費量: 約 8GB 〜 16GB
• 必要ユニファイドメモリ量: 最低 64GB(快適に使うなら 96GB / 128GB)
50万円前後のモデル構成と選び方

① M5 Max 搭載 Mac Studio(メモリ 64GB カスタマイズ / 約45万〜50万円):
◦ 70Bの4-bitモデル(Q4_K_MやIQ4_XS)が動作する。短〜中規模のコンテキスト長であれば問題なく運用可能。
② M5 Max 搭載 Mac Studio(メモリ 128GB カスタマイズ / 約65万〜75万円):
◦ 70Bの4-bitモデルが非常に余裕を持って動作する。長文コンテキスト(16k〜32kトークン以上)の処理や、より高精度な5-bit(Q5)量子化モデル、さらには100B〜120Bクラスの3-bit/4-bitモデルまで視野に入る。
生成速度の目安(Tokens per second)
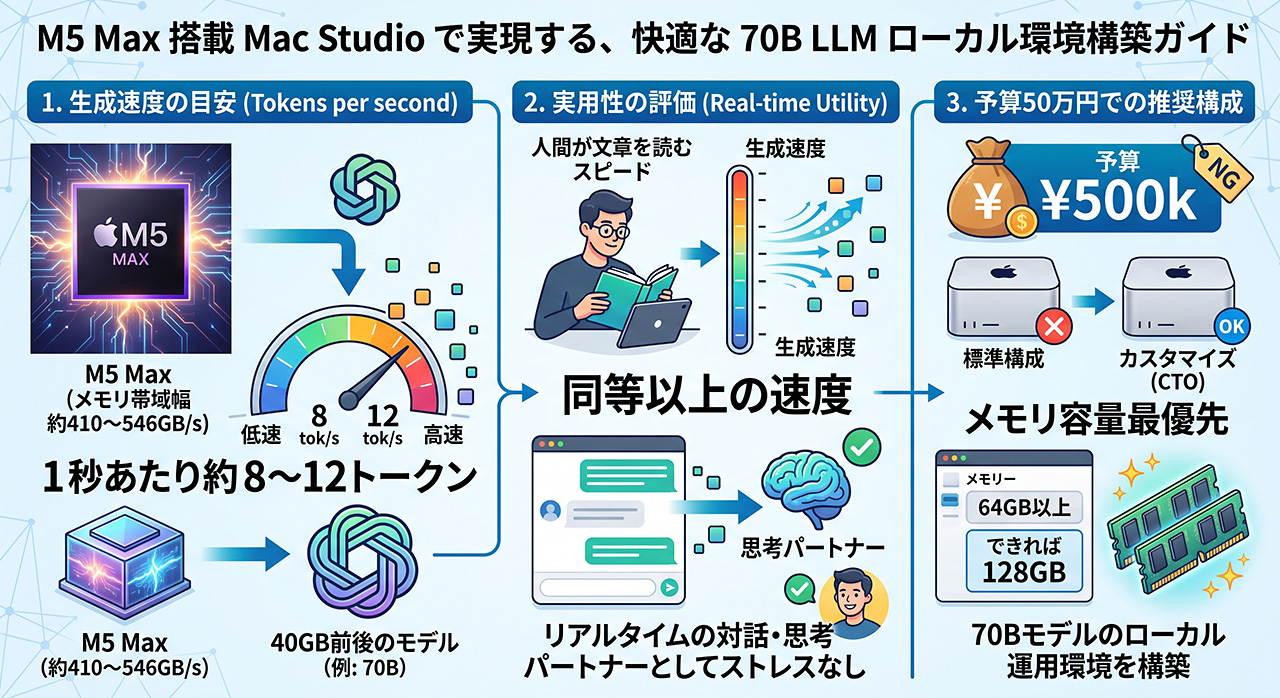
• M5 Max(メモリ帯域幅 約410GB/s〜546GB/s)で40GB前後のモデルを動かした場合、出力速度は 1秒あたり約8〜12トークン になる。
• 人間が文章を読むスピードと同等以上の速度で生成されるため、リアルタイムの対話や思考パートナーとしてストレスなく利用できる。
予算50万円で検討される場合は、標準構成ではなく「メモリ容量(64GB以上、できれば128GB)」を優先してカスタマイズしたMac Studioを選択することで、70Bモデルのローカル運用環境を構築できる。
結局、ローカルLLMに関してはMacの一人勝ち状態のようだ。
とはいっても、多くのWindowsユーザーがMacに乗り換えるか、と言えば世の中、そう簡単ではない。